开源的 AI 求职智能体。
English | Español | Deutsch | Français | Português (Brasil) | 한국어 | 日本語 | 简体中文 | 繁體中文 | Українська | Русский | Polski | Dansk | தமிழ் | العربية | हिन्दी | Türkçe | Tiếng Việt | Bahasa Indonesia
 由 @santifer 创建
几个月投出的简历,全都石沉大海。
于是我做了自己需要的那个过滤器。
740 个职位已评估。68 个已投递。12 次面试。1 份 offer。
我是它的第一个用户。我拿到了那份工作。然后把它开源了。
粘贴一个职位,它在你的机器上告诉你:还在不在招,适不适合你。
它为你定制简历、起草回答。由你点击提交。

我自己的求职,进行到一半,界面是西班牙语。
公司用 AI 筛选候选人。
我把 AI 交给候选人,让他们来挑选公司。
六个月后,我离开了那份工作。
现在我们打造 career-ops,让你也能上岸。

在我之后来的人,写下了他们是怎么拿到 offer 的。
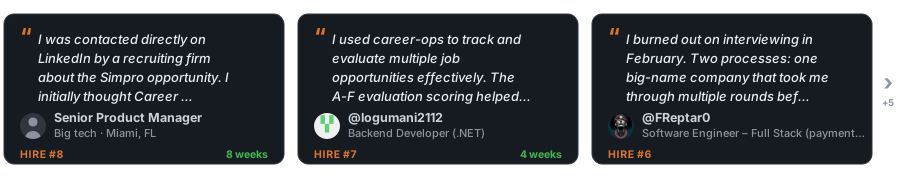
每张卡片都是一个可以打开的公开 issue。你也上岸了?留下你的卡片 →
⭐ 如果 career-ops 帮到了你,一颗星就能帮下一个人找到它。


把你今晚本来打算投的一个职位粘贴进来。如果返回的是不要投,你刚刚把这个晚上赢回来了。如果返回的是一份计划,你就知道下一步该做什么。
npx @santifer/career-ops init开源。本地运行。就在你已经在用的 AI CLI 里。包含免费模型和本地模型。
点下发送之后的沉默,与你无关。看到同一件事的人足够多,于是把这套实践写了下来,只有六行:
投得更少,投得更好。信号胜过数量。证据胜过关键词。由人来决定。本地优先。桌子两边都有尊严。

其中几位,用他们自己的话。
每一个签名都是一次可审计的提交。读完全部,或加上你的 →
招聘不会自己修好。正在经历它的人可以,而且他们已经在这个房间里,交换笔记,互相修各自的配置。
修复就是在这里写出来的。是房间,不是俱乐部。一起来建。

career-ops 对求职者永久免费。这些公司赞助了本项目:
SerpApi · Build a portfolio project with live search data. SerpApi gives developers structured JSON/Markdown from Google Search, Maps, Shopping, and other engines through a simple API call.
赞助买到的是清楚标注的曝光,绝不是影响力:再多的钱也改变不了路线图,也放不进产品里任何东西。赞助商绝不会出现在评估、排名或推荐中。
粘贴一个职位。它告诉你这个晚上值不值得。
- 还在招吗? 在你写下一个字之前,它先确认这个职位仍在招聘。
- 不是你? 用你真实的简历给职位打分,匹配度弱就让你跳过。你可以不听。
- 值得投? 它起草简历、求职信和申请答案。你来读。你来发。
- 该找谁聊? 它找到那个人,起草那条消息。它从不替你发出。
- 这些东西都去哪了? 每一份申请都留在你的机器上。没有任何东西上传给我们。
- 我该学什么? 连续被拒之后,它说出差距在哪。
最初几次运行会很粗糙。它还不了解你。跟它聊:你的简历、你想要什么、你拒绝什么。把它当成一个招聘顾问的第一周。
第一次启动时,它会在聊天里把这些都问一遍。没有任何需要手动配置的东西。
- 自动提交申请。 它为每个字段起草答案;你审阅,然后点击提交。脚本从不发出 POST(
prepare-application.mjs)。 - 发送邮件。 只写草稿。整个代码库里没有任何邮件发送模块。
- 回传数据。 没有遥测,没有我们的后端。你的简历只从你的机器发往你选择的 AI 提供商,不去任何别的地方。唯一的公开记录就是这个仓库:
HIRED.md和它的 issue。 - 催你申请低于 4.0/5 的职位。 它会告诉你别申请。你可以不听,它会明说。
它会改写你的简历,但绝不能编造。代码里有一道检查:PDF 里的数字或事实如果在你的简历和 article-digest.md 里都找不到,就会被拦下;但它还无法判断每一处改写。每份简历发出前都请自己读一遍。详情见 FAQ。
| 功能 | 说明 |
|---|---|
| A-H 评估 | 职位摘要、简历匹配(标注每条要求在这个职位里有多重要,以及权重来自职位描述的措辞、结构还是估算,逐条标注;估算永远不能进入最高档)、级别策略、薪酬调研、个性化、面试准备(STAR+R),再加上区块 G 的职位可信度检查(是否仍在招、是否为重复发布:只陈述观察,不下定论),以及一个工作许可信号(把明确不提供签证担保的职位描述标记为硬性阻碍) |
| Human-in-the-Loop | AI 评估并推荐,你决定并行动。系统从不提交申请:最终决定始终在你手中 |
| ATS PDF 生成 | ATS 可读的简历,基于你自己的经历、针对每份职位描述定制,采用 Space Grotesk + DM Sans 设计 |
| 求职信生成器 | 基于调研的求职信:关键词呼应、四个交互式角度提问(为什么/问题/方法/语气)、在聊天中审批草稿,以及通过与简历相同的 HTML + Playwright 流水线生成 A4 PDF。每次评估自动起草;用 /career-ops cover 按需完成并生成 |
| 简历之外 | 公司调研(deep)揭示 AI 战略、近期动向、工程文化,以及你的简历应该采取的角度。联系人发现(contacto)找出值得联系的招聘经理、招聘人员或团队成员,并起草一条不超过 300 字符、针对联系人类型调整过的 LinkedIn 消息。正式申请邮件草稿(email)把已评估的报告或粘贴的职位描述变成主题、正文和附件清单,不发送、不提交、不点击任何内容。申请让你排进队伍,调研让你获得对话。 |
| 模式分析 | 拒信模式和各 ATS 渠道的推进率(analyze-patterns.mjs)、整个求职周期的漏斗统计(stats.mjs)、重复发布检测,重复发布可能是幽灵职位的迹象(detect-reposts.mjs) |
它还能做的所有事
| 功能 | 说明 |
|---|---|
| 自动流水线 | 粘贴一个 URL,获得完整评估 + PDF + 追踪记录 |
| 面试故事库 | 跨评估积累 STAR+反思故事:5 到 10 个主故事,可以针对你遇到的行为面试问题灵活改编 |
| 谈判话术 | 薪资谈判框架、应对地域折价、利用竞争 offer 作为筹码 |
| 申请邮件草稿 | 从报告或粘贴的职位描述生成给招聘人员、内推或冷申请的正式邮件,包含主题、附件清单、有据可查的匹配点和来自你个人资料的联系信息块。仅限草稿:career-ops 从不发送、提交或点击任何内容。 |
| 招聘平台扫描器 | 预配置 100+ 家公司(Anthropic、OpenAI、ElevenLabs、Retool、n8n…)+ 跨 Ashby、Greenhouse、Lever、Wellfound 的自定义网页搜索查询 |
| 已融资公司发现 | 以审阅为先的 company:funded 命令从结构化的公开数据源中列出近期获得融资的公司和来源诊断,不改动你的数据 |
| 批量处理 | 用无头 CLI worker(claude -p / opencode run)并行评估 |
| Dashboard TUI | 在终端里浏览、筛选和排序你的流水线 |
| 流水线完整性 | 自动合并、去重、状态规范化、健康检查 |
| 面试套件 | 按时间块安排的准备计划、带反馈的练习环节、面试后复盘(interview/),以及公司危险信号检测器(interview-redflag) |
| Offer 阶段 | 合同阅读助手:逐条款解读加上给律师的问题清单(offer-prep),以及期望/公布/实际薪资差距分析器(salary-gap.mjs) |
| 跟进与回复 | 跟进节奏计算器和预置提醒(followup-cadence.mjs、followup-seed.mjs);把雇主回复归类为追踪记录更新(reply-watch) |
| 插件系统 | 可选集成(Gmail、Notion、Apify + 社区注册表),默认关闭;见 docs/PLUGINS.md |
最快的方式,一条命令:
npx @santifer/career-ops init💡
npx随 Node.js 一起提供:它只运行一次安装程序, 不会全局安装任何东西。还没有 Node?先安装它。 (已经在用 Claude Code / Codex CLI?那你已经有了。)
这会把最新版本克隆到 ./career-ops 并安装依赖。然后:
cd career-ops
claude   # or codex / qwen / opencode / agy / grok — open your AI CLI here
首次启动时,career-ops 会通过对话引导你完成设置(你的简历、个人资料和目标职位)。不需要手动编辑任何东西。
想手动设置?(git clone)
git clone https://github.com/career-ops-hq/career-ops.git
cd career-ops && npm install
npx playwright install chromium   # only needed for PDF generation
# On a non-Debian/Ubuntu Linux distro (Fedora, Arch, ...), Chromium's system
# libraries aren't installed by the line above — install them yourself with
# your distro's package manager if PDF generation fails to launch the browser
# (Playwright's own docs list the required libraries per platform).

# 2. Open your AI CLI in this directory. On first launch it walks you
#    through setup (your CV, profile and target roles) by chatting
claude   # or codex / opencode / qwen / agy / grok

# Then ask your CLI to adapt the system to you:
# "Change the archetypes to backend engineering roles"
# "Translate the modes to English"
# "Add these 5 companies to portals.yml"
# "Update my profile with this CV I'm pasting"

# 3. Start using
# Paste a job URL or JD text to trigger auto-pipeline
# If your CLI supports slash commands, use /career-ops (or its CLI-specific alias)
# In Codex, ask for the same mode in plain language, e.g.:
# "Run the career-ops scan mode"
# "Run the career-ops pipeline mode for data/pipeline.md"
# "Run the career-ops pdf mode for the latest evaluated role"
# "Run the career-ops tracker mode and summarize the current statuses"npm i -g @santifer/career-ops这会全局安装 career-ops 二进制文件,让你不用 npx 就能运行 career-ops init [folder]。init 是它唯一的命令:它只负责搭建工作区,之后的一切都在你的 AI 编码 CLI 里进行(见下方“用法”),而不是通过这个二进制文件。
该用哪个?
npx @santifer/career-ops init:最适合首次使用;会创建一个专用的项目文件夹。npm i -g @santifer/career-ops:如果你更想输入career-ops init而不是npx的写法。它不会增加其他命令。
这个系统就是设计成由你的 AI 编码 CLI 自己来定制的。 模式、原型、评分权重、谈判话术:直接让它改就行。它读取的正是它自己使用的文件,所以它清楚该改哪里。
完整安装指南见 docs/SETUP.md;用自定义或本地模型低成本运行 career-ops 的方法见 docs/RUNNING_ON_A_BUDGET.md(在 Antigravity CLI 免费层零成本运行见 docs/FREE_TIER.md);定时扫描和零 token 的"初筛到短名单"配方见 docs/AUTOMATION.md;ATS 自动填表流程的细节见 docs/APPLY_AUTOFILL.md;把 LinkedIn 联系人导出与漏斗中的公司交叉比对见 docs/LINKEDIN_JOIN.md;常见设置问题的解答见 docs/FAQ.md,包括故事溯源如何防止编造数字。设计原则在 ARCHITECTURE.md;运行时流程在 docs/ARCHITECTURE.md。
career-ops 使用共享的命令路由。在会注册斜杠命令的 CLI 里,它看起来是这样:
/career-ops           → 显示所有可用命令
/career-ops {JD}      → 自动流水线:评估 + 报告 + PDF + 追踪记录(粘贴文本或 URL)
/career-ops pipeline  → 处理收件箱里待处理的 URL(data/pipeline.md)
/career-ops oferta    → 仅评估,区块 A 到 H(不自动生成 PDF)
/career-ops ofertas   → 比较并排序多个职位
/career-ops contacto  → LinkedIn 妙招:找到联系人 + 起草消息
/career-ops deep      → 针对公司的深度调研提示词
/career-ops interview-prep → 生成针对特定公司的面试准备文档
/career-ops interview    → 交互式的个人资料/简历入门访谈
/career-ops master-profile → 导入、审阅并校验你的主职业档案(Master Career Profile)
/career-ops eu-swe    → 在简历/申请/面试前校准一份欧洲 SWE 申请
/career-ops interview/plan → 为即将到来的面试制定按时间块安排的准备计划
/career-ops interview/practice → 模拟面试,一次一个问题并给出反馈
/career-ops interview/debrief → 面试后复盘:补上短板,预测下一轮
/career-ops interview-redflag → 入职前分析雇主的危险信号
/career-ops pdf       → 仅生成 PDF,ATS 优化简历
/career-ops text      → 定制的 markdown 简历(镜像 cv.md,不生成 PDF)
/career-ops latex     → 把简历导出为 LaTeX/Overleaf .tex
/career-ops latex-tex → 就地定制你自己的 resume.tex(可选;cv.md 仍是默认)
/career-ops cover     → 求职信:单独粘贴职位描述,或 /career-ops cover {slug}
/career-ops email     → 正式申请邮件草稿(仅草稿;从不发送、提交或点击)
/career-ops add       → 向简历添加项目/论文/职位(抓取 + 预览 + 确认)
/career-ops expand    → 从个人资料链接自动发现并补充缺失的能力
/career-ops training  → 对照你的 North Star 评估课程/证书
/career-ops project   → 评估一个作品集项目点子
/career-ops tracker   → 申请状态总览
/career-ops agent-inbox → 为下一个会话排队/清空请求(data/agent-inbox.md)
/career-ops apply     → 实时申请助手(读取表单 + 生成答案)
/career-ops scan      → 扫描招聘平台并发现新职位
/career-ops discover  → 把公司列表解析为可扫描的 ATS 板块 + 追加到 portals.yml(零 token)
/career-ops batch     → 用并行 worker 批量处理
/career-ops patterns  → 分析拒信模式并改进目标定位
/career-ops offer-prep → 和候选人一起阅读收到的 offer/合同:逐条款解读 + 给律师的问题(不是法律建议)
/career-ops titles    → 根据你的简历推荐相近的职位名称以扩大搜索范围
/career-ops upskill   → 基于已评估报告的综合技能差距分析
/career-ops followup  → 跟进节奏追踪:标记逾期,生成草稿
/career-ops reply-watch → 归类雇主回复并建议追踪记录更新
/career-ops outcome   → 记录申请结果并归档产物
/career-ops calibrate → 咨询性报告:你的评估分数能预测真实结果吗?读取 /outcome 数据;从不改变评分
/career-ops update    → 更新 career-ops 系统文件,带 diff 预览 + 兼容性检查
或者直接粘贴一个职位 URL 或描述:career-ops 会自动识别并运行完整流水线。
Codex 里不保证有斜杠命令。请改用同样的模式名称写在提示词里,或者通过 codex exec 调用。
You paste a job URL or description
        │
        ▼
┌──────────────────┐
│  Archetype       │  Classifies: LLMOps / Agentic / PM / SA / FDE / Transformation
│  Detection       │
└────────┬─────────┘
         │
┌────────▼─────────┐
│  A-H Evaluation  │  Match, gaps, comp research, STAR stories, legitimacy
│  (reads cv.md)   │
└────────┬─────────┘
         │
    ┌────┼────┐
    ▼    ▼    ▼
 Report  PDF  Tracker
  .md   .pdf  entry
career-ops 原生支持 Antigravity CLI,方式和支持 Claude Code、OpenCode 一样。所有斜杠命令都通过共享的 skill 入口提供,使用相同的 modes/*.md 评估逻辑。
Google 已把消费者版 Gemini CLI 的访问迁移到 Antigravity CLI。GEMINI.md 现在是一个不做任何事的兼容性守卫,这样 Antigravity 在同时读取 AGENTS.md 和 GEMINI.md 时不会重复加载完整的项目指令。
# 1. Run in the career-ops directory
cd career-ops
agy

# 2. Use the unified /career-ops command with subcommands:
/career-ops "Senior AI Engineer at Anthropic..."
/career-ops pipeline
/career-ops scan
/career-ops pdf
/career-ops tracker
这个 skill 按开放标准定义在 .agents/skills/career-ops/SKILL.md 中,并为每个支持的 CLI(例如 .claude/、.qwen/、.antigravitycli/、.grok/)建立了符号链接或引用。 Cursor 会自动发现 .agents/skills/ 中的共享 skill。
career-ops 通过同一个共享路由支持 Codex,但调用方式和自动注册斜杠命令的 CLI 不同。完整指南见 docs/CODEX.md。
cd career-ops
codex
Codex 里不保证有斜杠命令。如果 /career-ops 不可用,就用自然语言让 Codex 直接运行对应模式:
Evaluate this JD with career-ops auto-pipeline: https://company.com/jobs/123
Run the career-ops scan mode and summarize new matches.
Run the career-ops pipeline mode for data/pipeline.md.
Run the career-ops pdf mode for the latest evaluated role.
Run the career-ops tracker mode and summarize the current statuses.
codex exec "Evaluate this JD with career-ops auto-pipeline: https://company.com/jobs/123"
codex exec "Run career-ops scan mode in this repo and summarize new matches."
codex exec "Run career-ops pipeline mode for data/pipeline.md."
codex exec "Run career-ops pdf mode for the latest evaluated role."
codex exec "Run career-ops tracker mode and summarize the current statuses."career-ops 原生支持 Grok Build CLI,方式和支持 Claude Code、OpenCode 一样。AGENTS.md 会作为项目规则自动加载,所有斜杠命令都通过共享的 skill 入口提供。
# 1. Run in the career-ops directory
cd career-ops
grok

# 2. Use the unified /career-ops command with subcommands:
/career-ops "Senior AI Engineer at Anthropic..."
/career-ops pipeline
/career-ops scan
/career-ops pdf
/career-ops tracker
无头批量 worker 请使用 grok -p "prompt"(加上 --yolo 可自动批准工具执行)。
career-ops 原生支持 Pi,不需要维护任何包装文件:Pi 会把仓库根目录的 AGENTS.md 读作项目上下文,并自行发现位于 .agents/skills/career-ops/SKILL.md 的共享 skill。之后路由就能以 /skill:career-ops 的形式使用。
# 1. Run in the career-ops directory
cd career-ops
pi

# 2. Use the shared skill with subcommands:
/skill:career-ops "Senior AI Engineer at Anthropic..."
/skill:career-ops pipeline
/skill:career-ops scan
/skill:career-ops pdf
/skill:career-ops trackerpi -p "Evaluate this JD with career-ops auto-pipeline: https://company.com/jobs/123"
pi -p "Run career-ops scan mode and summarize new matches."
pi -p "Run career-ops tracker mode and summarize the current statuses."如果某个 Pi 版本要求先对项目资源做信任确认,就在仓库里运行一次 /trust,然后重启 pi,让项目 skill 加载(/trust 对之后启动的 Pi 进程生效);或者用 -a 启动,它只信任单次运行,不需要重启。
# 1. Get a free API key at https://aistudio.google.com/apikey
cp .env.example .env
# Edit .env, set GEMINI_API_KEY=your_key_here

# 2. Install dependencies
npm install

# 3. Evaluate a job description
node gemini-eval.mjs "We are looking for a Senior AI Engineer..."
node gemini-eval.mjs --file ./jds/my-job.txt
node agent-inbox.mjs add "..."   # queue a request for the next session
npm run gemini:eval -- "JD text here"
免费层: 两种方式都无需付费。原生 CLI 使用 Google OAuth;API 脚本使用
gemini-3.6-flash(速率限制取决于模型和层级;当前配额见 Google AI 文档)。
扫描器自带 100+ 家公司可直接扫描,以及覆盖主流招聘网站的 35+ 条搜索查询。把 templates/portals.example.yml 复制为 portals.yml,再添加你自己的:
AI 实验室: Anthropic、OpenAI、Mistral、Cohere、LangChain、Pinecone 语音 AI: ElevenLabs、PolyAI、Parloa、Hume AI、Deepgram、Vapi、Bland AI AI 平台: Retool、Airtable、Vercel、Temporal、Glean、Arize AI 联络中心: Ada、LivePerson、Sierra、Decagon、Talkdesk、Genesys 企业级: Salesforce、Twilio、Gong、Dialpad LLMOps: Langfuse、Weights & Biases、Lindy、Cognigy、Speechmatics 自动化: n8n、Zapier、Make.com 欧洲: Factorial、Attio、Tinybird、Clarity AI、Travelperk
搜索的招聘网站: 55+ 个提供方模块覆盖 ATS API、整站数据源、XML/RSS 源、markdown 源和本地解析器。完整表格见支持的招聘网站。
默认情况下 node scan.mjs(即 npm run scan)信任每个 ATS 数据源返回的内容。有些公司在职位关闭后仍会把过期职位留在公开 API 里,这些过期条目可能会混进 pipeline.md。加上 --verify 可以在 API 阶段之后启动 Playwright,在过期职位进入流水线之前把它们剔除:
node scan.mjs --verify # zero-token discovery + Playwright liveness check验证是顺序执行的,并且只针对新职位(去重之后),所以成本是有上限的。
内置的终端仪表板让你可视化地浏览你的流水线:
npm run serve:dashboard   # launch the TUI
npm run build:dashboard   # optional: build the standalone binary
功能:10 个筛选标签、8 种排序模式、分组/平铺视图、延迟加载预览、内联状态修改。
还有一个实验性的 Web UI(alpha 版,可选:除非你主动启动,否则不会运行任何东西):见 web/README.md。
career-ops/
├── AGENTS.md                    # Canonical agent instructions (all CLIs)
├── CLAUDE.md                    # Claude Code wrapper (imports AGENTS.md)
├── CODEX.md                     # Codex wrapper (imports AGENTS.md)
├── OPENCODE.md                  # OpenCode wrapper (imports AGENTS.md)
├── GEMINI.md                    # Legacy no-op guard to avoid Antigravity duplicate context
├── cv.md                        # Your CV (create this)
├── article-digest.md            # Your proof points (optional)
├── config/
│   └── profile.example.yml      # Template for your profile
├── modes/                       # Skill modes
│   ├── _shared.md               # Shared context (customize this)
│   ├── oferta.md                # Single evaluation
│   ├── pdf.md                   # PDF generation
│   ├── cover.md                 # Cover letter generation
│   ├── email.md                 # Formal application email drafts
│   ├── scan.md                  # Portal scanner
│   ├── batch.md                 # Batch processing
│   └── ...
├── templates/
│   ├── cv-template.html         # ATS-optimized CV template
│   ├── portals.example.yml      # Scanner config template
│   └── states.yml               # Canonical statuses
├── batch/
│   ├── batch-prompt.md          # Self-contained worker prompt
│   └── batch-runner.sh          # Orchestrator script
├── dashboard/                   # Go TUI pipeline viewer
├── data/                        # Your tracking data (gitignored)
├── reports/                     # Evaluation reports (gitignored)
├── output/                      # Generated PDFs (gitignored)
├── fonts/                       # Space Grotesk + DM Sans
├── docs/                        # Setup, customization, budget guide, architecture
└── examples/                    # Sample CV, report, proof points
默认情况下,用户层数据(如 cv.md、portals.yml,以及 data/、reports/、output/ 文件夹)位于项目根目录内。
为了把个人数据和代码分开(更方便切换分支、拉取更新或测试多个个人资料),你可以按以下优先级配置一个外部数据目录:
- 环境变量: 设置
CAREER_OPS_ROOT或CAREER_OPS_DATA_DIR环境变量:export CAREER_OPS_ROOT=~/my-career-data
- 标记文件: 在仓库根目录创建一个
.career-ops-data文件,内容是你的数据目录路径。 - 默认: 使用仓库根目录。
解析完成后,所有用户文件都相对于该文件夹解析和写入,而提示词文件和脚本仍然相对于仓库解析。
- 覆盖追踪文件: 你也可以设置
CAREER_OPS_TRACKER直接覆盖申请追踪文件的路径。 - 写入: 所有写入操作(如合并)都以
{DATA_ROOT}/data/applications.md为规范目标。 - 扫描器配置:
portals.yml在{DATA_ROOT}/portals.yml读取和校验,所以node validate-portals.mjs检查的正是scan.mjs读取的那个文件。 - 生成的文档: 定制简历和求职信写入
{DATA_ROOT}/output/,把它们关联到报告的 PDF 清单位于{DATA_ROOT}/data/pdf-index.tsv。在未设置CAREER_OPS_TRACKER时,限定这些写入范围的追踪工作区是数据根目录,而不是代码检出目录。 - 追踪文件覆盖下的 PDF:
generate-pdf.mjs会先解析CAREER_OPS_TRACKER,再推导工作区,所以设置了覆盖时,工作区就是存放该追踪文件的文件夹(如果追踪文件位于data/文件夹中,则是它的上一级文件夹)。这时简历的 HTML 和每个 PDF 都必须位于该工作区内,清单也会移到它的data/pdf-index.tsv。求职信仍以{DATA_ROOT}/output/为目标,所以当该文件夹不在追踪文件的工作区内时,求职信会被拒绝写入。 - 代码层保持不动:
node_modules/、providers/、modes/以及脚本本身始终相对于仓库解析,从不相对于数据根目录。
Go 版仪表板 TUI、Node.js 脚本和 AI 代理模式都会自动遵循这一解析层级。


- 代理:带共享 skill 和模式的 AI 编码 CLI(
AGENTS.md+ 各 CLI 的包装) - PDF:Playwright + HTML 模板
- 求职信:HTML 模板 + Playwright(A4 PDF,与简历相同的流水线)
- 扫描器:Playwright + Greenhouse API + WebSearch
- 仪表板:Go + Bubble Tea + Lipgloss(Catppuccin Mocha 主题)
- 数据:Markdown 表格 + YAML 配置 + TSV 批处理文件

也可以在任何遵循 agent skill 标准的 CLI 中运行。见支持的 CLI。





- cv-santiago:作品集网站(santifer.io),带 AI 聊天机器人、LLMOps 仪表板和案例研究。如果你需要一个配合求职展示的作品集,fork 它,改成你自己的。
career-ops 是什么? career-ops(career-ops.org,也称 careerops) 是一个开源的 AI 求职工具,在你的 AI 编码 CLI(Claude Code、Codex、OpenCode 等)里本地运行,把每一个决定都留给你。它根据你的简历评估职位,生成适配 ATS 的 PDF,找到合适的联系人,并在一个地方追踪所有进展:最终决定始终在你手中。它是 CareerOps 宣言的首个参考实现。
定制简历会编造内容吗?
不应该,提示词里也这么写:只改写,绝不编造。generate-pdf 会拦下数字或事实在你的资料来源中找不到的简历,除非你传入 --skip-fact-check。pdf 模式还会运行 cv-title-check.mjs:它按公司和日期,把定制简历中的每个职位名称与 cv.md 中同一份工作的职位名称对比,有不同就请你决定保留还是改回。它只提醒、不拦截,因为调整职位名称的写法有时是你自己的选择。目前还没有任何检查评判改写:#1411(不通过即阻止的真实性检查)在跟进这一点。在此之前,每份简历发出前都请自己读一遍。法律声明 用更长的篇幅说了同样的话。
我可以免费运行 career-ops,或使用更便宜的本地模型吗? 可以。career-ops 不受特定 CLI 限制,可以用免费和本地模型运行(OpenRouter 免费模型、Ollama 或任何兼容 OpenAI 的端点),因此你不必绑定付费订阅。完整设置见 docs/RUNNING_ON_A_BUDGET.md。
我付了 Claude Pro/Max,但 career-ops 在消耗 API 额度。为什么?
因为环境里的 ANTHROPIC_API_KEY 优先于你已登录的订阅:CLI 会使用这个密钥并按 token 计费。运行 echo $ANTHROPIC_API_KEY,如果有输出,就把它从 shell 配置里删掉,重启终端并运行 /login。批量模式是例外,因为 claude -p worker 不使用交互式登录:运行一次 claude setup-token,把结果导出为 CLAUDE_CODE_OAUTH_TOKEN。完整步骤见 docs/RUNNING_ON_A_BUDGET.md。
career-ops 支持哪些 AI CLI? career-ops 通过开放的 Agent Skill Standard 运行在任何主流 AI 编码 CLI 上(Claude Code、Codex、Gemini / Antigravity、OpenCode、Grok、Qwen 等),所以永远不会被单一厂商锁定。用你已经有的 CLI 就行。
如何在 Windows 上安装 career-ops? career-ops 可以在 Windows 上运行。平台相关的设置和已知的坑(Git Bash 检测、行尾符、任务计划程序)在 docs/WINDOWS.md。如果安装时因符号链接错误导致 skills 无法加载,解决方法在 docs/FAQ.md。完整步骤见 docs/SETUP.md。
career-ops 会替我自动申请职位吗? 不会。career-ops 是一个过滤器,不是海投的自动申请器。AI 负责评估、排序和起草;你负责审阅与决定。它起草、填写,但从不提交。由你点击提交。这种保留人工决策的设计正是重点所在。
career-ops 是免费开源软件吗? 是。career-ops 是免费开源软件,而且对求职者会一直如此。它是 CareerOps 宣言的首个参考实现。读一读,如果它说出了你的想法,就签名。
我是 Santiago Fernández de Valderrama Aparicio(santifer),曾经是创业者:我创办并卖掉了一家至今仍以我的名字运营的公司。我打造 career-ops 是为了管理自己的求职,它奏效了:它帮我拿到了一个 Head of Applied AI 的职位。六个月后,我离开了那个职位,全职投入 career-ops 的开发。
想知道这么大的仓库,是怎样由一支 AI 代理团队维护、每次合并都由人来决定的?读一读 Agentic maintenance: how career-ops is run by a fleet of AI agents。
我的作品集和其他开源项目 → santifer.io
Wikidata:Santiago Fernández de Valderrama Aparicio · career-ops。
career-ops 是一个本地运行的开源工具,不是托管服务。 使用本软件即表示你确认:
- 你掌控自己的数据。 你的简历、联系方式和个人数据留在你的机器上,直接发送给你选择的 AI 提供商(Anthropic、OpenAI 等)。我们不收集、不存储、也无法访问你的任何数据。
- 你掌控 AI。 默认提示词指示 AI 不要自动提交申请,但 AI 模型可能出现不可预测的行为。如果你修改了提示词或使用其他模型,风险自负。提交前务必检查 AI 生成内容的准确性。
- 你遵守第三方条款。 你必须按照所交互招聘平台(Greenhouse、Lever、Workday、LinkedIn 等)的服务条款使用本工具。不要用本工具向雇主发送垃圾信息或冲击 ATS 系统。
- 不作任何保证。 评估是建议,不是事实。AI 模型可能虚构技能或经历。作者不对就业结果、被拒的申请、账号限制或任何其他后果负责。
完整内容见 LEGAL_DISCLAIMER.md。本软件依据 MIT 许可证"按原样"提供,不附带任何形式的保证。
每一位贡献过代码、文档、翻译或测试的人都列在 CONTRIBUTORS.md 里,包括上面的图表无法展示的 非代码贡献。
用 career-ops 找到工作了?分享你的故事!
代码以 MIT 许可证发布。"career-ops" 的名称和 品牌受商标政策约束:对社区使用宽松, 对商业产品命名和背书保留权利。
由 Santiago Fernández de Valderrama Aparicio(@santifer)创建并维护